GenRec @ Home: Qwen2.5 ve LoRA ile Lokal Fine-Tuning ve Film Önerisi
Published:
⚠ Dikkat bir hayli uzun yazı ⚠
Çok uzun zamandır aklımda dönen bir soru vardı; “evde LLM fine tune edebilir miyim?” Netflix’in ağustosta yayımladığı GenRec makalesini okuduğumdan beri bu soru “bir LLM’i öneri modeline çevirmek evde tek bir ekran kartıyla ne kadar mümkün?” olarak değişti. Makalede yüz milyarlarca etkileşim, 1B-10B parametreli modeller ve vLLM ile servis edilen bir sistem anlatılıyor. Bunu nasıl yapabilirim, ne kadar veriyle, hangi modelle, ne kadar sürede ve ne kadar iyi sonuç alabilirim sorularıyla yola çıktım. Bu yazıda da bu sorulara yanıt arayacağım.
İlk olarak makaleyi birebir kopyalamaya çalışmadım. Onu bir yol haritası gibi kullanıp aynı adımları MovieLens 25M üzerinde küçük ölçekte uyguladım. Amacım lokalde bir LLM’i nasıl fine-tune edeceğimi, nelere ihtiyaç duyduğumu, nerelerde takılacağımı ve sonunda elimde gerçekten kullanılabilir bir şey olup olmayacağını görmekti. Kısa cevap: hiçbir şey olmasa bile kesinlikle bir şeyler oldu. Kullanıcının puan geçmişini alıp 16 bin filmlik bir katalogdan ~50 ms’de öneri döndüren bir API’m var. Uzun cevap biraz daha karışık çünkü basit bir Markov baseline’ı bu modelden yaklaşık 3 kat daha isabetli. İkisini de anlatacağım.
Giriş
Klasik öneri sistemleri kullanıcıyı ve ürünü birer ID olarak görür; etkileşim matrisi (interaction matrix), embedding’ler (temsiller), benzerlikler (similarities). LLM tabanlı yaklaşımda ise kullanıcının geçmişi metne çevriliyor (“şu filme 4 puan verdi, buna 2.5…”) ve model bu metni okuyup bir sonraki adımı tahmin ediyor. Buradan iki yol çıkıyor. Birincisi modelin bir sonraki filmin adını üretmesi (generation). Kulağa doğal gibi gelse de hem yavaş hem de modelin katalogda olmayan bir film uydurma ihtimali yüksek. İkinci seçenek ise LLM’i bir encoder gibi kullanmak. Prompt’u modelden bir kez geçirip son token’ın gizli durumunu (hidden state) kullanıcı vektörü olarak almak ve tüm kataloğu tek bir matris çarpımıyla skorlamak. GenRec ikinci yolu seçiyor, herhangi bir metin üretilmediği için buna prefill-only scoring1 deniyor.
Makaledeki kurgu iki faza (phase) sahip:
Phase 1: Açık kaynak bir LLM’i domain verisiyle (katalog metinleri, kullanıcı geçmişleri) continued pretraining ile eğitip Netflix’in “dilini” öğretmek. Burada sıralama yok sadece next-token tahmini var.
Phase 2: Aynı modeli sıralama için post-training’den geçirmek. Backbone katalog farkında bir scoring head ve öğrenilen item embedding’leri tüm katalog üzerinde softmax cross-entropy ile birlikte eğitiliyor. Buna bir joint LM loss (language model loss) ve bir reward-weighted loss ekleniyor.
Makalenin iddiası Phase 1’in hazır (off-the-shelf) bir modele göre MRR‘da +%10-20, Phase 2’nin ise +%35-50 kazanç sağladığı yönünde. Prompt uzunluğunu ~5000 token’dan ~1700’e indirdiklerini ve sistemi trafiğin ~%10’unda 4 hafta A/B testinden geçirdiklerini de anlatıyorlar. Anlatmadıkları da az değil. Phase 1’in tarifi ve veri büyüklüğü, Phase 2’deki örnek sayıları, reward modelleri, loss ağırlıkları, prompt formatı. Yol haritası var ama haritanın bazı yerleri boş oralarda biraz ChatGPT ve Claude’nin yaratıcılığından faydalandım.
Bu yaratıcılıkları da biraz sınırlamak için her zaman olduğu gibi işe birkaç net kısıt koyarak başladım.
- Windows üzerinde tek GPU: RTX 4060 Ti (16 GB VRAM), Windows 10, miniforge3 ortamı (Python 3.11, torch 2.11 + CUDA 12.6, transformers & peft).
- Küçük model: Qwen2.5-0.5B (base). 16 bin sınıflı bir softmax ve LoRA ile birlikte 16 GB’a rahat sığması ve 1024 token’lık bağlamda (context) saniyede birkaç bin token işleyebilmesi gerekiyordu.
- Veri: MovieLens 25M. Netflix’in izleme verisi elimde olmadığı için görev “sıradaki izlenecek film” değil “sıradaki puanlanacak film” oldu. Zaten literatürde kabul görmüş benim de sıklıkla kullandığım bir veri seti.
Makaleyle bu çalışma arasındaki eşleşme kabaca şöyle:
| Makale (GenRec) | Bu çalışma |
|---|---|
| ~1B-10B backbone, yüz milyarlarca etkileşim | Qwen2.5-0.5B, MovieLens 25M (25M puan) |
| Phase 1: domain continued pretraining | LoRA ile 10M ve 30M token’lık continued pretraining |
| Phase 2: backbone + head + item embedding’leri birlikte | Frozen probe, sıfırdan uçtan uca (end-to-end) ve LP-FT |
| Full-catalog softmax, prefill-only scoring | Var: 16139 film, tek forward pass |
| Joint LM loss, reward-weighted loss | Yok |
| vLLM ile servis, A/B testi | Python’un kendi http.server‘ı ile lokal API, offline değerlendirme |
Her ne kadar sınırları belirtmiş olsam da normalde kullanmayı pek tercih etmediğim (en azından bu çalışmadaki kadar çok) bat script’leri ve
http.serverkullanımı ChatGPT’nin seçimi oldu. Pek müdahale etmedim açıkçası!
Veri ve Problem Kurgusu
MovieLens 25M veri seti ~162 bin kullanıcının ~62 bin filme verdiği 25 milyon puandan ve kullanıcıların filmlere yazdığı 1.1 milyon tag’den oluşuyor. Puanların zaman damgasını kullanarak veriyi dört döneme ayırdım. Ayrım puanların zamana göre %80, %90 ve %95’lik yüzdeliklerine denk geliyor:
| Dönem | Bitiş | Kullanım |
|---|---|---|
| Phase 1 | 2016-06-25 | Continued pretraining korpusu (20M puan) |
| Phase 2 train | 2018-01-04 | Sıralayıcının eğitim örnekleri |
| Validation | 2018-12-23 | Model seçimi ve tüm ara kararlar |
| Test | sonrası | Yalnızca en sonda, bir kez |
Phase 2: Bir kullanıcının son 20 puanına bakarak bir sonraki puanlayacağı filmi 16 bin filmlik bir katalogda sıralamak. Katalog Phase 2 train döneminde en az 5 kez “sıradaki film” olmuş filmlerden oluşuyor (warm item 2). Kullanıcının daha önce puanladığı filmler sıralamadan çıkarılıyor. Eğitim için 100 bin örnek seçtim (her katalog filminin en az 5 pozitif örneği olacak şekilde) validation ve test için ise 5’er bin örnek.
Modelin gördüğü prompt aşağıdaki gibi. Her satırda film adı, verilen puan, türler ve Phase 1 döneminde o filme en sık yazılmış 2 tag var 👇🏻
Task: Predict the next movie this anonymous member will rate.

Recent ratings, oldest to newest:
1. "Mr. Right (2016)" - rating 3.5/5 - genres: Action, Comedy, Romance - tags: hitman, romance
2. "Transporter, The (2002)" - rating 4.5/5 - genres: Action, Crime - tags: jason statham, cars
...
18. "Bad Boys II (2003)" - rating 4.0/5 - genres: Action, Comedy, Crime, Thriller - tags: nudity (topless), michael bay
19. "Rock, The (1996)" - rating 4.0/5 - genres: Action, Adventure, Thriller - tags: sean connery, nicolas cage
20. "Whole Nine Yards, The (2000)" - rating 4.0/5 - genres: Comedy, Crime - tags: bruce willis, matthew perry

Next movie:
Bir prompt ortalama ~800 token tutuyor. 1024 token’lık bağlam prompt’ların %99’unu kesmeden alıyor. Sığmayan birkaç tanesi ise baştan yani en eski puanlardan kırpılıyor. Bu kullanıcının puanladığı sıradaki film Salt (2010) idi. Modelin bunu kaçıncı sıraya koyduğunu yazının sonunda göreceğiz.
Değerlendirmede ana metrik olarak NDCG@20‘yi seçtim. Gerçek film ilk 20’de ne kadar yukarıdaysa skor o kadar yüksek. Yanında Recall@20, MRR ve coverage@20‘ye de baktım. Coverage@20, 5000 kullanıcının ilk 20 listelerinde en az bir kez görünen filmlerin kataloğa oranı. Bir modelin herkese aynı popüler filmleri önerip önermediğini anlamanın en kolay yolu bu. Aynı kullanıcı validation’da birden fazla kez yer alabildiği için güven aralıklarını kullanıcı bazında bootstrap ile (user-clustered bootstrap) hesapladım. İki modeli karşılaştırırken de farkları aynı örnekler üzerinde eşleştirdim (paired).
LLM’in gerçekten bir şey öğrenip öğrenmediğini görmek için işe iki baseline ile başladım. Biri en popüler filmleri öneren popularity baseline3. Diğeri ise kullanıcının son filmlerinden sonra en sık hangi filmlere geçildiğini sayan basit bir item transition (Markov) modeli. İkincisinin bu kadar güçlü çıkacağını hiç tahmin etmemiştim, ona sonuçlar kısmında döneceğim.
MovieLens’te çok sayıda puan aynı saniyede girilmiş (kullanıcı bir sayfada toplu puanlama yapmış). Bu durumda “sıradaki” film aslında yalnızca movieId sırasına göre belirleniyor. Bu tür satırlar train’in %18’ini, validation’ın %7’sini oluşturuyor ve bir modelin kullanıcı davranışı yerine bu sıralamayı öğrenmesi mümkün.
Phase 1: Modele MovieLens Dilini Öğretmek
Phase 1’in amacı modele sıralama öğretmek değil MovieLens dünyasını tanıtmak. Hangi film hangi yılın, hangi türün, hangi tag’lerle anılıyor, kullanıcılar puanlarken nasıl bir sıra izliyor. Bunun için Phase 1 dönemindeki (2016 ortasına kadar) veriden üç tip belge ürettim 👇🏻
# catalog (34461 belge)
Movie: Toy Story.
Release year: 1995.
Genres: Adventure, Animation, Children, Comedy, Fantasy.
Member-generated tags observed before the Phase-1 cutoff: pixar, animation, disney, tom hanks, computer animation.

# history (345152 belge)
Chronological rating history for an anonymous member:
1. Lord of the Rings: The Two Towers, The (2002) - 4.0/5
2. Back to the Future Part III (1990) - 2.5/5
...

# rich history (345152 belge)
Chronological ratings and movie attributes for an anonymous member:
1. Lord of the Rings: The Two Towers, The (2002) - rating: 4.0/5 - genres: Adventure, Fantasy - tags: fantasy, based on a book, high fantasy
...
Belgelerde kullanıcı veya film ID’si yok, tag’ler de yalnızca kesim tarihinden önce yazılmış olanlardan seçildi. Bağlamın (corpus) tamamı ~490M token ediyor. Hepsini eğitmek bu donanımda günler sürerdi. Bu yüzden iki alternatif denedim; 10M ve 30M token. Katalog belgeleri bir kez kalan alternatif yarı yarıya history ve rich history olacak şekilde.
Eğitimin kendisi standart bir LoRA continued pretraining:
- LoRA: r=16, α=32, dropout 0.05, tüm lineer katmanlarda (
q, k, v, o, gate, up, down). 503M parametrenin yalnızca 8.8 milyonu (%1.75) eğitiliyor. - Bağlam ve paketleme: 1024 token. Belgeler EOS ile birleştirilip 1024’lük dizilere paketleniyor (sequence packing). Belgelerin %99’u 935 token’ın altında. 512 token seçseydim ~147M token’ı kesmem gerekecekti.
- Optimizasyon: bf16, AdamW, lr 1e-4, %3 warmup, tek epoch. Her güncellemede 32 dizi, yani 32768 token.
Bu kısımdaki asıl dert VRam yönetimiydi. İlk denemede micro-batch’i 4, gradient accumulation’ı 8 yaparak başladım. PyTorch’un raporladığı maksimum bellek 21.6 GB çıktı. Linux’ta bu doğrudan CUDA out of memory hatası demek. Windows’ta ise eğitim hata almadı ama bir hayli yavaşladı (saniyede ~175 token). Olası açıklama bir tür memory offload durumuydu. VRAM dolunca Windows sürücüsü taşan kısmı hata vermeden sistem RAM’ine (shared GPU memory) aktarıyor. NVIDIA bu davranışa sysmem fallback diyor (bildiğimiz out of memory işte ) ve sürücü ayarlarındaki “CUDA - Sysmem Fallback Policy”4 ile kapatılabiliyor. Kapatınca Linux’taki gibi doğrudan hata alınıyor. GPU her adımda veriyi PCIe üzerinden RAM’den okumak zorunda kaldığı için de iş bir hayli yavaşlıyor. Micro-batch’i 2’ye düşürüp gradient accumulation’ı 16’ya çıkardığımda maksimum bellek 11.4 GB’a indi ve hız ~3500 token/sn’ye çıktı. Yani ~20 kat artış yakayabildim burada. Windows’ta bellek taşması (memory offload) hata olarak değil yavaşlık olarak geri dönüyor. Uzun bir eğitime başlamadan önce birkaç adımlık bir deneme yapıp torch.cuda.max_memory_allocated()‘a bakmak ve Görev Yöneticisi’nde veya nvidia-smi ile (ki ben MSI Afterburner bile takip ettim) “Shared GPU memory”nin artmadığından emin olmak gerekiyor.
Bu aşama için özellikle ChatGPT’den direkt bunu test eden bir script yazmasını istedim. GPU kullanımına en başta emin olamadığım için varsayım yerine birkaç test ile elimde karşılaştırılabilir bir şeyler olmasını ve ona göre planlama yapmak istedim. Amacım günlerce sürecek bir eğitim yapmak değil tam tersi görece küçük bir veriden hızlı ve güvenilir bir tahmin almaktı.
Bu ayarlarla 10M token 51 dakika, 30M token 2 saat 22 dakika sürdü.
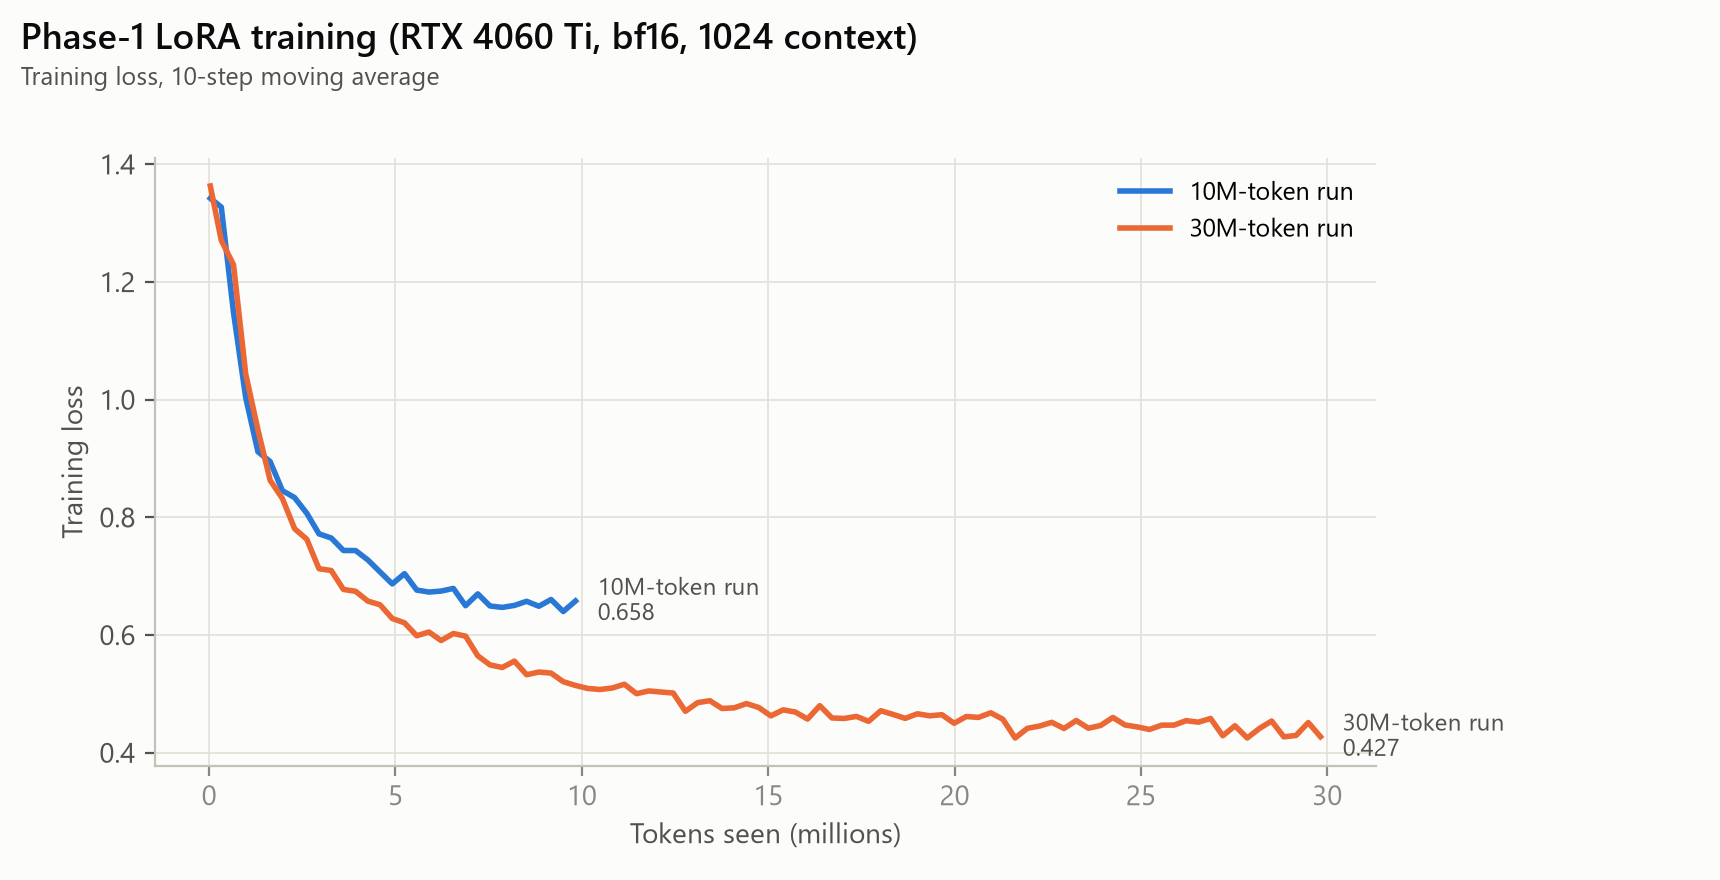
Ayrılmış (hold-out) verideki kayıp da beklendiği gibi düştü:
| Belge tipi | Base | 10M | 30M |
|---|---|---|---|
| Catalog | 2.015 | 1.440 | 1.431 |
| History | 0.990 | 0.571 | 0.488 |
| Rich history | 1.439 | 0.577 | 0.355 |
Hata bu kadar düşünce insan “model kullanıcıları anlıyor herhalde” diye düşünüyor. Phase 2’ye geçmeden önce hatanın nereden düştüğüne baktım. Belgelerdeki her token’ı rolüne göre ayırıp (film adı, puan, tür, tag, biçim) her rol için ayrı ayrı kayıp hesapladım. Kaybın birimi NAT: modelin doğru token’a verdiği olasılığın doğal logaritmasının eksisi (-ln p). 0 nat modelin doğru token’ı kesin bildiği anlamına geliyor. 1 nat ise doğru token’a ~%37 (e⁻¹), 3 nat ise ~%5 olasılık vermiş demek. Grafikteki nat/token da bir rolün token’ları üzerinden bu değerin ortalaması 👇🏻
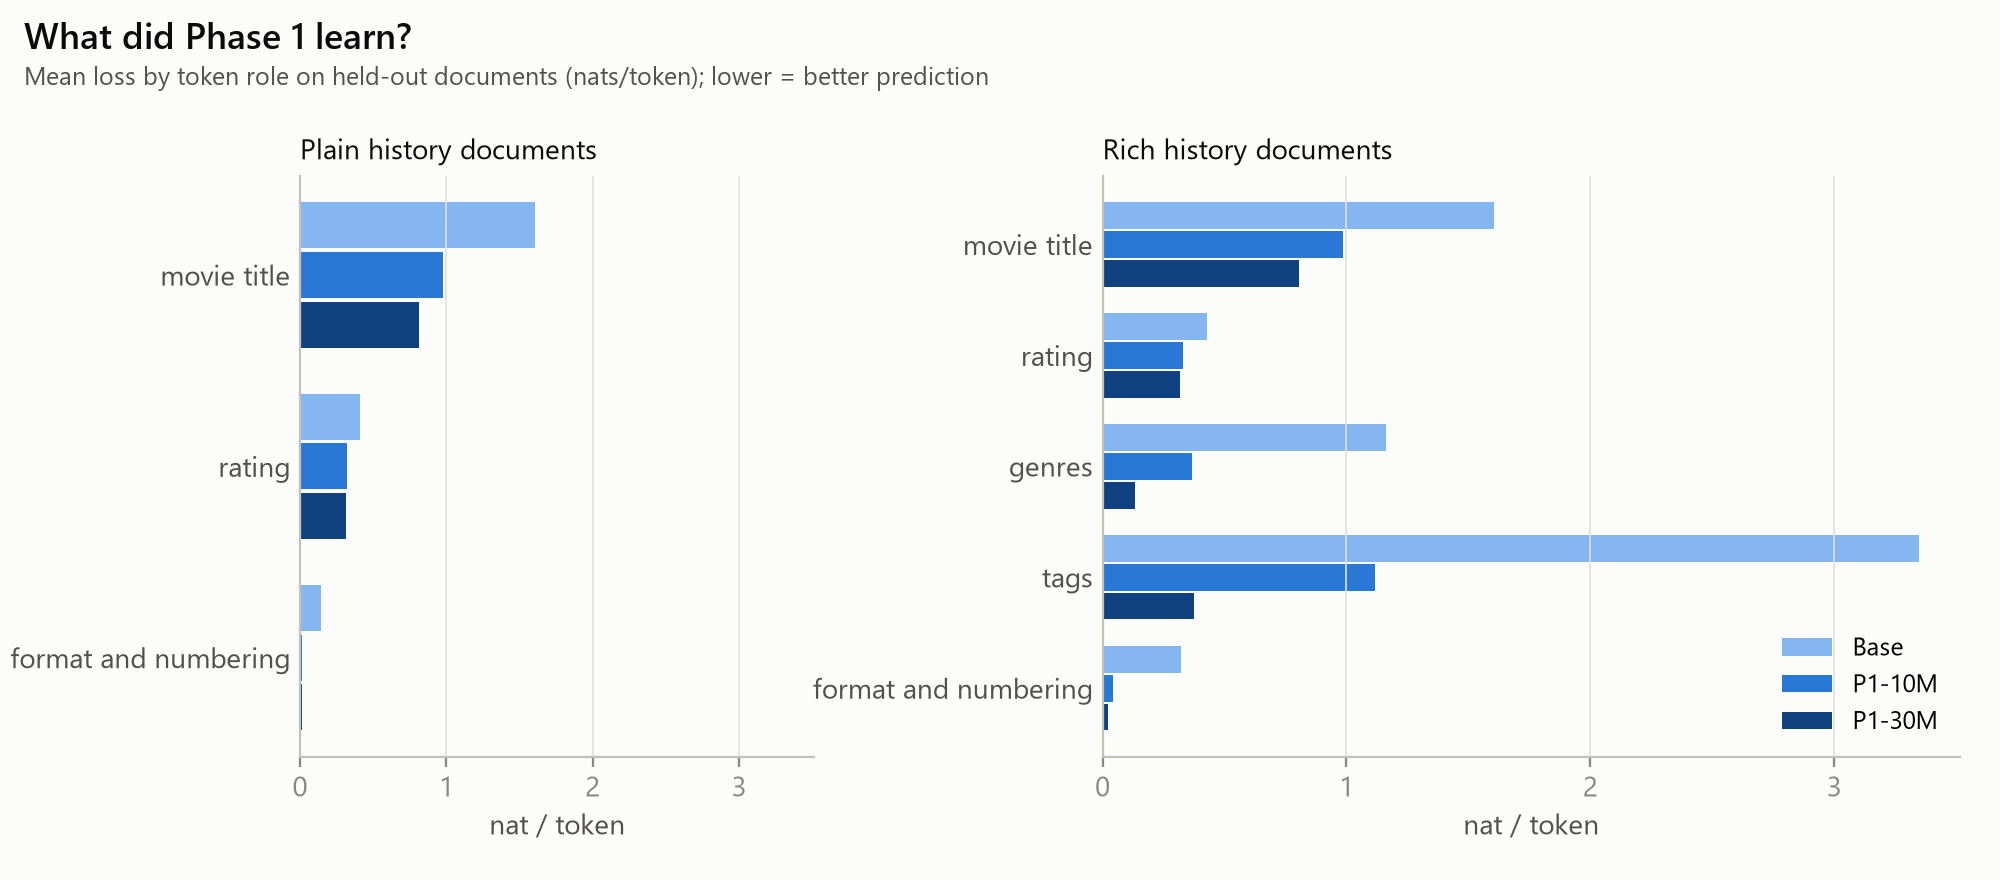
Grafik pek iç açıcı değil. Rich history belgelerindeki düşüşün ~%64’ü tür ve tag token’larından geliyor. Bunlar filme bağlı, katalogdan ezberlenebilen bilgiler. Model “Toy Story”den sonra pixar, animation geleceğini öğrenmiş. Film adlarındaki kazancın büyük kısmı da geçmişten bağımsız, yani model hangi filmlerin var olduğunu ve adlarının nasıl yazıldığını öğrenmiş. Kullanıcının geçmişinin bir sonraki filmi tahmin etmeye gerçek katkısını ayrıca ölçtüğümde film başına yalnızca ~1.3-1.5 nat çıktı. 10M’den 30M’ye geçerken bu katkı neredeyse hiç artmadı, ek token’lar daha çok katalog bilgisine gitti.
Yani Phase 1 modele MovieLens kataloğunu iyi öğretti, kullanıcı davranışını ise çok az. Bunun sıralamaya yansıyıp yansımadığını Phase 2 gösterecek.
Phase 2: LLM’den Sıralayıcıya
Phase 2’de modelden bir kullanıcı vektörü alıp onu 16139 filmle karşılaştıran bir head kurmak gerekiyor. Kullanıcı vektörü olarak prompt’un son token’ının (Next movie: satırının sonu) son katmandaki gizli durumunu kullandım. Qwen2.5-0.5B’de bu 896 boyutlu bir vektör. Causal bir modelde son token tüm prompt’u görmüş tek token olduğu için doğal bir özet.
Head’i tasarlarken popülerliği modelin içine açıkça koydum:
skor(kullanıcı, film) = log(popülerlik[film]) + scale · cos(W · LayerNorm(x), e_film)
class PopularityAwareHead(nn.Module):
    def __init__(self, in_dim, catalog_size, projection_dim, train_prior):
        super().__init__()
        self.user_norm = nn.LayerNorm(in_dim)
        self.projection = nn.Linear(in_dim, projection_dim, bias=False)   # 896 -> 256
        self.item_embeddings = nn.Embedding(catalog_size, projection_dim)  # 16139 x 256
        self.log_scale = nn.Parameter(torch.tensor(0.0))
        self.register_buffer("train_prior", train_prior)                  # log(popülerlik)

    def score(self, x, prior=None):
        user = F.normalize(self.projection(self.user_norm(x)), dim=-1)
        items = F.normalize(self.item_embeddings.weight, dim=-1)
        base = self.train_prior if prior is None else prior
        return base[None, :] + self.log_scale.exp() * (user @ items.T)
Formül iki parçadan oluşuyor:
- Önsel (Prior):
log(popülerlik)filmin kişiden bağımsız, herkes için aynı olan skoru. Bir filmin Phase 2 train döneminde kaç kez “sıradaki film” olduğunun logaritması. - Etkileşim terimi:
scale · cos(...)kullanıcı vektörüyle filmin embedding’i arasındaki benzerlik. Kişiselleştirmeyi taşıyan kısım bu.e_filmher film için öğrenilen 256 boyutlu bir embedding,W896’dan 256’ya bir projeksiyon,scaleda etkileşim teriminin ağırlığını belirleyen ve öğrenilen tek bir sayı.
Bu tasarımın iki faydası var. Birincisi model eğitime bir popularity baseline’ı olarak başlıyor (scale küçükken skor neredeyse tamamen popülerlik). Böylece etkileşim terimi yalnızca popülerliğin üstüne kişiselleştirme eklemekle uğraşıyor. İkincisi popülerliği ayrı tuttuğum için eğitim ile gerçek hayat arasındaki dağılım farkını düzeltebiliyorum. Eğitim örneklerini her film en az 5 kez geçecek şekilde seçtiğim için eğitim setindeki popülerlik gerçeğinden çok daha düz. Eğitimde bu düz dağılımı, tahmin anında ise Phase 2 train dönemindeki gerçek popülerliği kullanıyorum (label shift düzeltmesi). Kayıp olarak tüm katalog üzerinde softmax cross-entropy kullandım. Model her örnekte 16139 filme birer olasılık dağıtıyor ve doğru filme verdiği olasılık ne kadar yüksekse kayıp o kadar düşük oluyor. Kullanıcının daha önce puanladığı filmler bu hesaba hiç girmiyor (maskeleniyor), çünkü zaten puanlanmış bir filmi önermenin anlamı yok. Kodun doğru çalıştığından emin olmak için de basit bir kontrol koydum. Etkileşim terimi kapalıyken model yalnızca prior’a, yani popülerliğe göre sıralama yapıyor. Bu durumda ayrıca hesapladığım popularity baseline’ıyla birebir aynı sonucu almayı bekliyorum. Aynı değilse ya puanlanmış filmleri çıkarma (maskeleme) adımında ya da popülerlik değerlerinde bir hata var demektir. Bu kontrol her karşılaştırmada geçti.
Bu head’i üç farklı şekilde eğittim. Her birini iki model varyantı üzerinde denedim. Phase 1’i hiç görmemiş Base Qwen ve Phase 1 adaptörü takılmış P1 (P1-30M: 30M token’lık adaptör). Asıl soru bu ikisi arasındaki fark:
| Tarif | Backbone | Head | Veri | GPU süresi |
|---|---|---|---|---|
| Frozen probe | Donuk | Sıfırdan, 5 epoch | 100K | Özellik çıkarma 1-2 saat, eğitim ~15 sn |
| Sıfırdan | LoRA | Sıfırdan | 30K | 1.2 saat |
| LP-FT | LoRA | Probe’un head’inden | 100K | ~3.3 saat / varyant |
Frozen probe: Probe (probing), donmuş bir modelin içinde bir görevi çözmeye yetecek bilginin olup olmadığını, üstüne yalnızca küçük bir model eğiterek ölçme yöntemi. Model yerinde duruyor sadece yokluyoruz. Burada küçük model yukarıdaki head. Backbone’u dondurup her örnek için son token vektörünü bir kez çıkarıp diske yazdım ve head’i bu cache üzerinden eğittim. Makaledeki kurgu bu değil (orada backbone da eğitiliyor) ama süre açısından avantajlı bir ilk ölçüm yöntemi.
Sıfırdan eğitim (e2e): Makaleye en yakın kurgu. Backbone’a LoRA ekleyip taze bir head ile birlikte 30K örnekte eğittim. Sonuç olarak hiçbir şey öğrenmedi 😂. Validation NDCG@20 popülerlik seviyesinde başladı ve her değerlendirmede biraz daha düştü (0.0230’dan 0.0203’e). Önce kod hatası sandım ama değildi. Head’in etkileşim terimi probe’da bile ancak ikinci epoch’ta yani 100K ile 200K örnek geçişi arasında “açılıyordu”. Ondan önce optimizasyon popülerliğin üstüne bir şey koyamıyor dolayısıyla 30K örnek bu eşiğin çok altında kalıyor. Sıfırdan eğitim süre açısından çok uzun süreceği için maalesef böyle kaldı.
LP-FT (linear probe, then fine-tune): Literatürde bulunan bir yöntem. Önce donuk backbone üzerinde head’i eğitiyorsun (linear probe) sonra backbone’u bu hazır head’den başlayarak fine-tune ediyorsun. Her varyant kendi probe head’inden başladı, LoRA ve head birlikte 100K örnekte eğitildi. Hazır head ilk adımlarda bozulmasın diye head’in öğrenme oranlarını 10 kat düşürdüm. Saniyede ~7200 token, ~6 GB VRAM ve varyant başına ~3.3 saat.
Sonuçlar
Karşılaştırmaların hangi sonuca nasıl karar vereceğini koşmadan önce config’e yazmıştım. Her aşama için tek bir ana karşılaştırma (P1 - Base, NDCG@20) ve sırayla uygulanan bir kural var 👇🏻
protocol:
  primary:
    split: "validation"
    inference_prior: "population_prior"
    metric: "ndcg@20"
    comparison: ["p1_30m", "base"]
  seeds: [1, 2, 3]
  # 1. Etkileşimsiz head, popularity baseline'ını birebir üretmeli; yoksa "gate_a_failed"
  # 2. En az bir varyant popülerliği geçmeli (CI > 0); yoksa "inconclusive"
  # 3. Fark CI'ı > 0 -> "p1_helps", < 0 -> "p1_hurts", 0'ı içeriyorsa "no_detectable_difference"
Test setini yalnızca bir kez tüm kararlar validation’da verildikten sonra kullandım. Ana tablo:
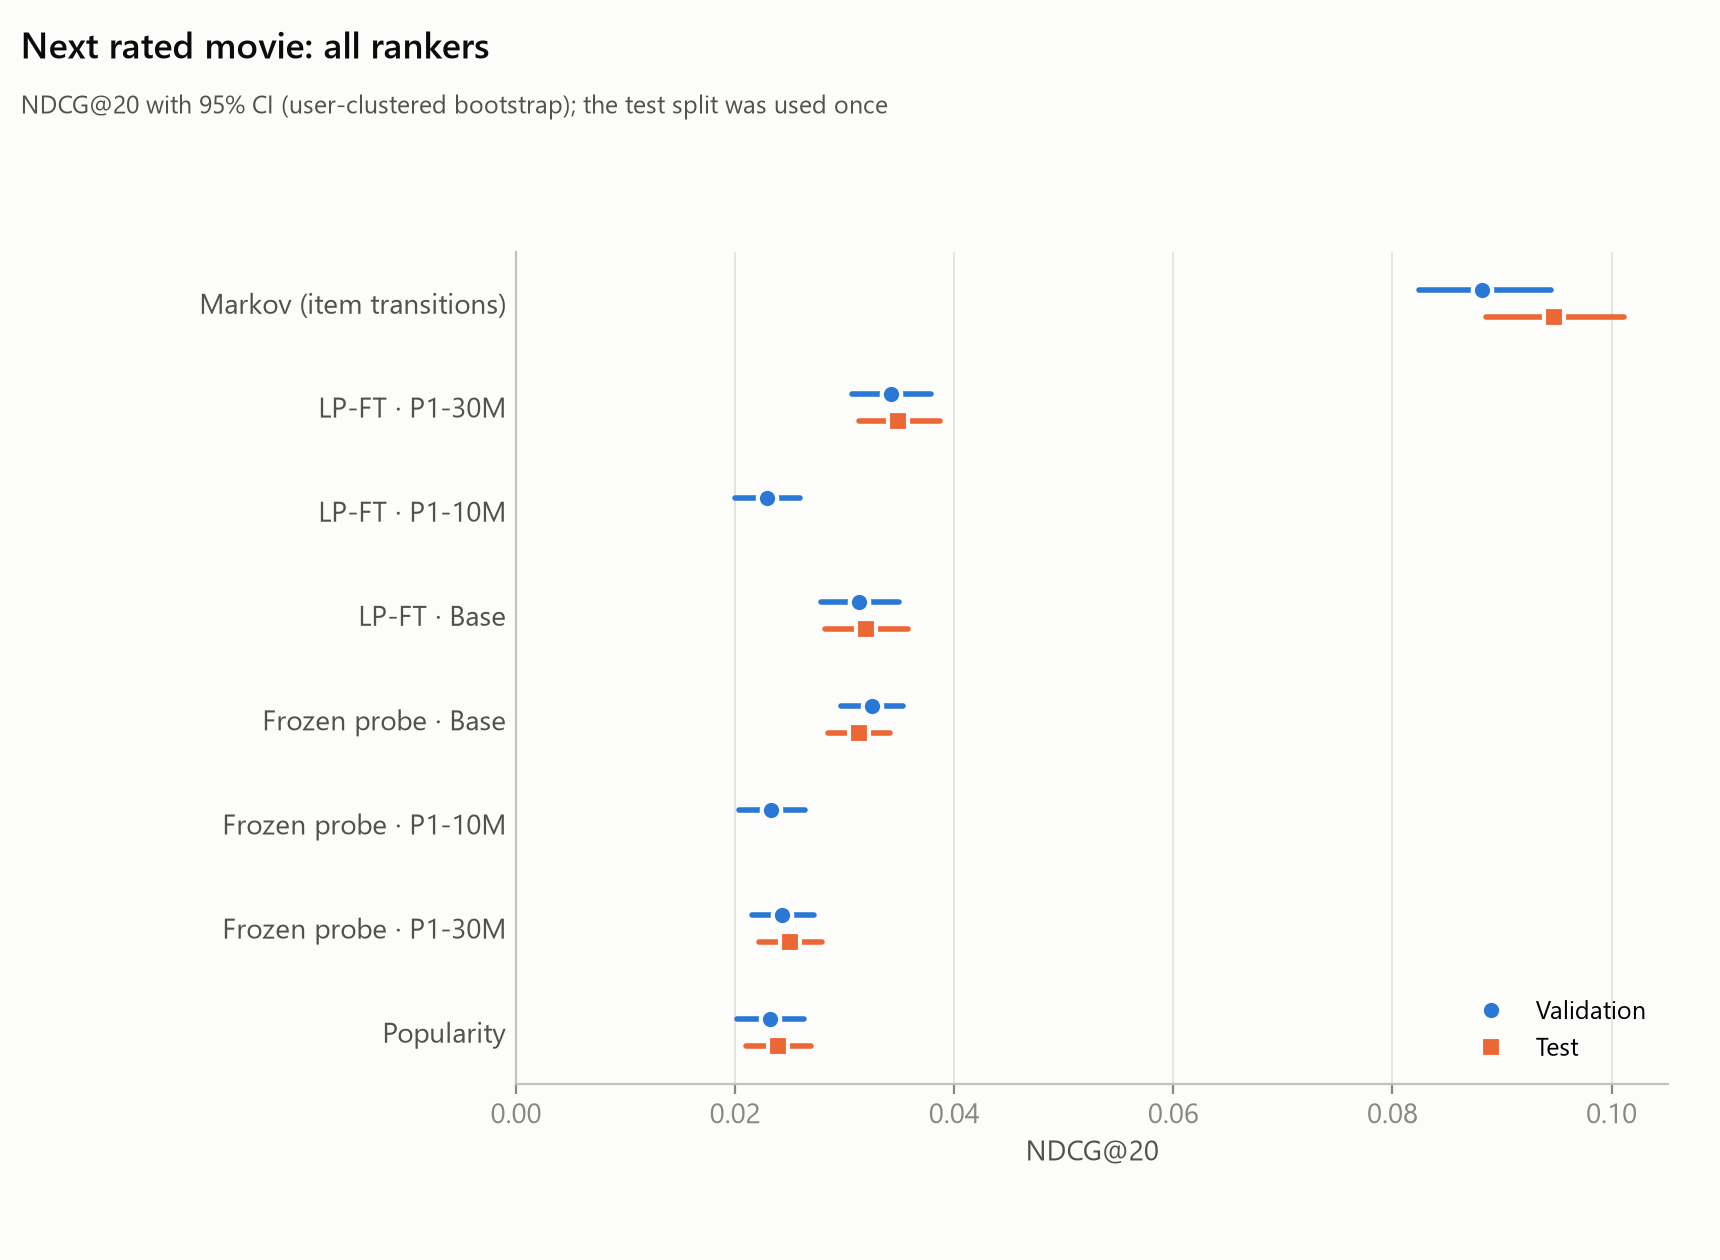
| Sıralayıcı | Val NDCG@20 | Test NDCG@20 | Test Recall@20 | Test coverage@20 |
|---|---|---|---|---|
| Popularity | 0.0232 | 0.0239 | 0.063 | %3.0 |
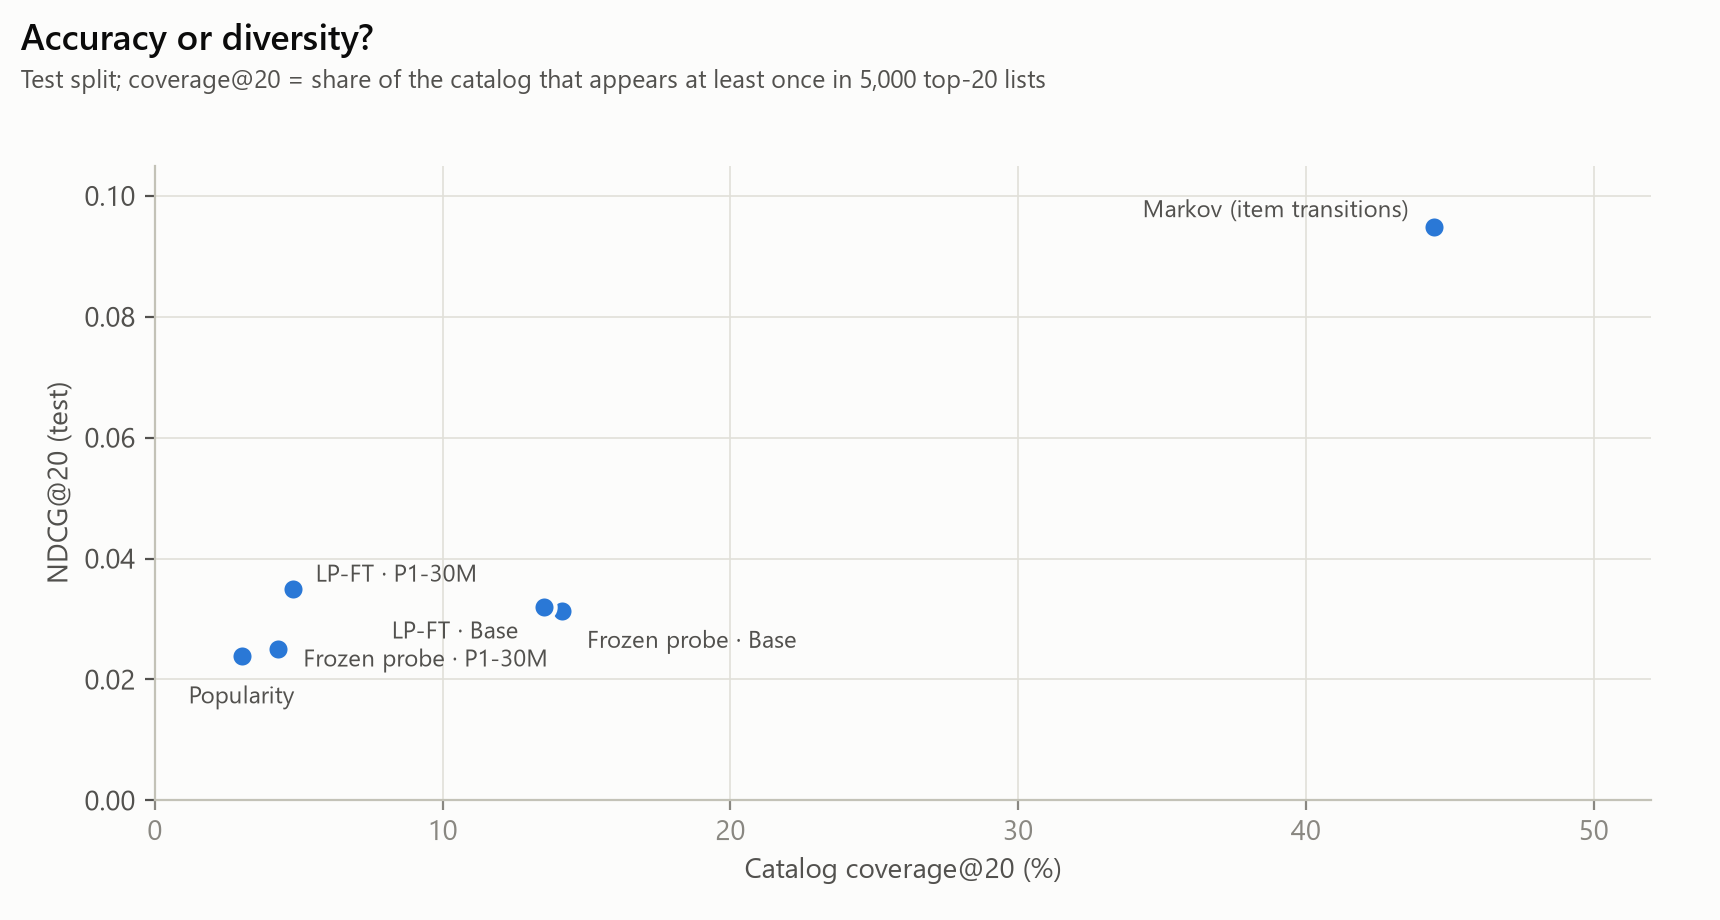
| Frozen probe · Base (3 seed) | 0.0325 | 0.0313 | 0.078 | %14.2 |
| Frozen probe · P1-30M (3 seed) | 0.0243 | 0.0250 | 0.066 | %4.3 |
| LP-FT · Base | 0.0313 | 0.0319 | 0.078 | %13.5 |
| LP-FT · P1-30M | 0.0342 | 0.0349 | 0.088 | %4.8 |
| Markov (item transitions) | 0.0882 | 0.0948 | 0.208 | %44.4 |
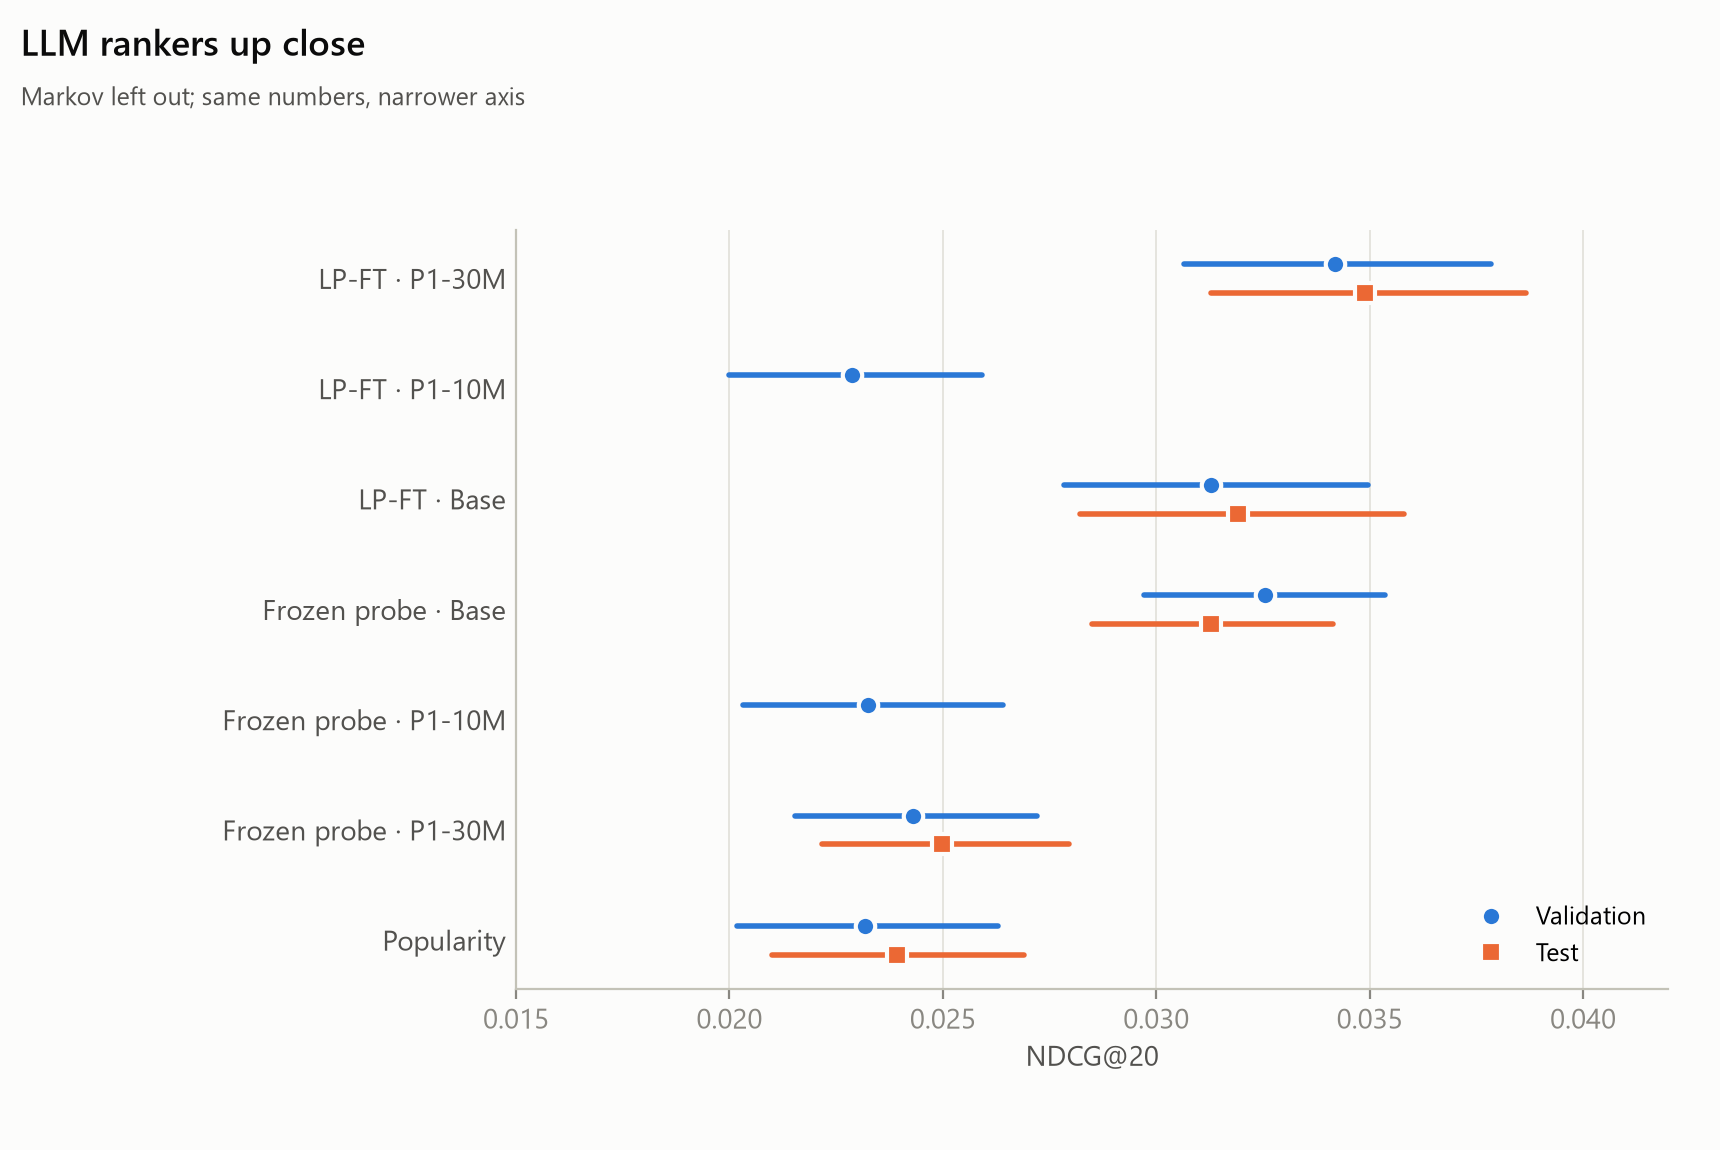
İki ana karşılaştırmanın sonucu (P1-30M - Base, test, %95 güven aralığı):
- Frozen probe: -0.0063 [-0.0093, -0.0033] ➡
p1_hurts_frozen. Donuk temsilde Phase 1 zarar veriyor. - LP-FT: +0.0030 [-0.0009, +0.0069] ➡
no_detectable_difference. Backbone eğitilince fark kayboluyor.
Validation ve test birbirine çok yakın çıktı.
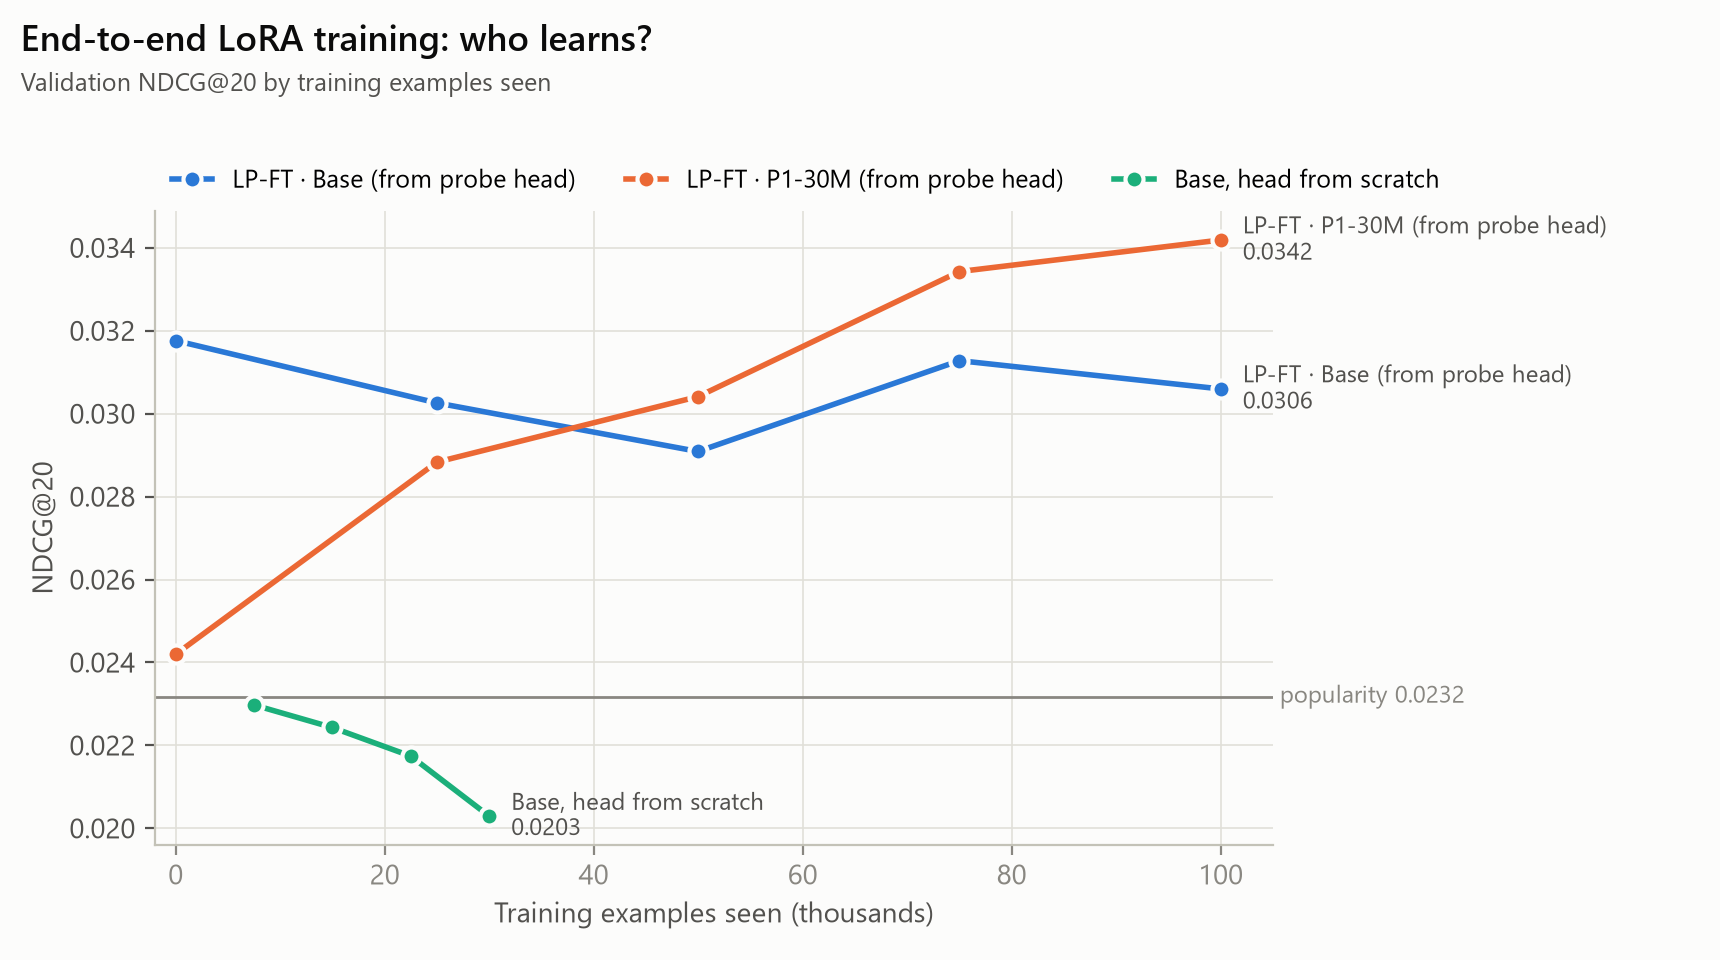
LP-FT eğrisi de ilginç. Base varyantı probe head’inden 0.0318 ile başlıyor ve fine-tuning ona hiçbir şey katmıyor (-0.0005). P1-30M vayantı ise zayıf bir noktadan (0.0242) başlayıp eğitim boyunca sürekli yükseliyor (+0.0100) ve son değerlendirmede hala yükseliyordu. “Phase 1 fine-tuning’den daha çok yararlanıyor” demek cazip ama vayantlar farklı noktalardan başladığı için çok adil bir karşılaştırma değil.
Tablonun sürprizi ise Markov. Kullanıcının son 20 filminden sonra en sık hangi filmlere geçildiğini sayan ve (CPU’da) bir dakikada hesaplanan bir model. Test’te 0.095 NDCG@20 ile en iyi LLM sıralayıcısının neredeyse 3 katı. Coverage’ı da %44, yani herkese farklı şeyler öneriyor.
Markov film kimliklerini ve on milyonlarca puandan çıkarılan geçiş istatistiklerini doğrudan kullanıyor. LLM ise yalnızca 20 filmlik bir metni ve 100K eğitim örneğini görüyor. Ayrıca LLM sıralayıcılarının kazancının tamamı en popüler filmlerde (popülerliğe göre en üst çeyrek). Diğer üç çeyrekte (validation hedeflerinin ~%10’u) NDCG@20 sıfır. Kuyruktaki bir film için 5-20 pozitif örnekle öğrenilen embedding pek bir şey ifade etmiyor.
Aynı saniyede girilen puanları da kontrol ettim. Validation’da LP-FT P1’in Base’e üstünlüğünün yarısı bu satırlardan geliyordu (bu satırlarda +0.0219, diğerlerinde +0.0015). Phase 1 belgelerinde de aynı saniyedeki puanlar movieId sırasıyla dizildiği için P1’in bu sırayı öğrenmiş olması mümkün. Test’te bu yoğunlaşma güçlü biçimde tekrarlanmadı. Yani kanıtlanmış bir etki değil ama bir ihtimal.
Phase 1 neden “zararlı” göründü?
Buraya kadar hikaye “Phase 1 bu ölçekte işe yaramadı, donukken zararlı bile” şeklindeydi. Sonra bir ölçek vayantı ekledim ve 10M token’lık Phase 1 adaptörünü (P1-10M) aynı akıştan (pipeline) geçirdim. Sonuç ilk bakışta daha da kötü. Önceden yazdığım kural P1-10M için de p1_hurts_frozen dedi (probe -0.0093, LP-FT -0.0084, validation). Ama sayılara bakınca bir tuhaflık vardı. P1-10M’in probe’u da LP-FT’si de popülerliğin tam üstündeydi (0.0233 ve 0.0229, popülerlik 0.0232). Yani model kötü öğrendi demek biraz iyimser olur. Model hiç öğrenmemiş (baba akü yok).
Eğitim log’larından scale parametresine baktım. Base’de scale ilk epoch’tan sonra hızla büyüyor ve hata 9.37’den 7.74’e iniyor. P1 varyantlarında ise scale önce düşüyor. Yani optimizasyon etkileşim terimini kapatıp popülerliğe güveniyor. P1-30M 5. epoch’ta ancak toparlanmaya başlamıştı. P1-10M’i ise early stopping tam toparlanırken kesmişti. LP-FT de bu ölü head’den başladığı ve head’in öğrenme oranı 10 kat düşük olduğu için 100K örnekte başarılı olamadı. Yani 10M ile 30M arasındaki fark Phase 1’in token sayısından çok head’in hangi noktadan başladığıyla ilgiliydi.
Peki bu neden yalnızca P1 varyantlarında oluyor? Frozen probe için diske yazdığım kullanıcı vektörlerine geri döndüm. Head’in yaptığı gibi her vektörü önce LayerNorm’dan geçirdim ve sonra kullanıcıların birbirine ne kadar benzediğini üç ölçüyle karşılaştırdım:
- Ortalama kosinüs benzerliği: Rastgele iki kullanıcının vektörleri arasındaki açının kosinüsü. 1 olması tüm kullanıcıların aynı yöne baktığı anlamına geliyor.
- Kullanıcıya özgü kısmın payı: Vektördeki değerlerin karelerinin toplamına (enerji) bakıp bunu iki parçaya ayırdım: herkeste ortak olan kısım (ortalama vektör) ve kullanıcıdan kullanıcıya değişen kısım (varyans). Head’in kişiselleştirme için kullanabileceği tek şey ikincisi.
- Effective rank: Bu kullanıcıya özgü kısmın kaç bağımsız yöne yayıldığı.
| Base | P1-10M | P1-30M | |
|---|---|---|---|
| Kullanıcılar arası ortalama kosinüs benzerliği | 0.952 | 0.996 | 0.995 |
| Kullanıcıya özgü kısmın payı (varyans / toplam enerji) | %4.83 | %0.37 | %0.47 |
| Effective rank | 263 | 33 | 62 |
Phase 1’den sonra farklı kullanıcıların son token vektörleri neredeyse aynı yöne bakıyor. Kullanıcıya özgü sinyal ortak bileşene göre 10 kat küçülmüş ve birkaç boyuta sıkışmış. Dil modellerinde temsillerin dar bir koni içinde toplanması (anisotropy) bilinen bir durum. Phase 1 bunu belirgin şekilde artırmış. Rastgele başlatılmış bir kosinüs head’i için ise tüm kullanıcılar neredeyse aynı vektör gibi görünüyor. Etkileşim terimi her kullanıcıya aynı katkıyı veren ikinci bir film sabitine dönüşüyor, popülerlik prior’ıyla çatışıyor ve optimizasyon en kolay yolu seçip scale‘i kısıyor.
Bilgi gerçekten kayboldu mu yoksa yalnızca “görünmez” mi oldu? Bunu test etmek için probe’un girdisini standartlaştırdım. Her boyuttan train setindeki ortalamayı çıkarıp standart sapmaya böldüm. Böylece tüm kullanıcılarda ortak olan bileşen siliniyor:
mean, std = train_x.mean(0), train_x.std(0).clamp_min(1e-6)
train_x, val_x = (train_x - mean) / std, (val_x - mean) / std
Sonuç 👇🏻
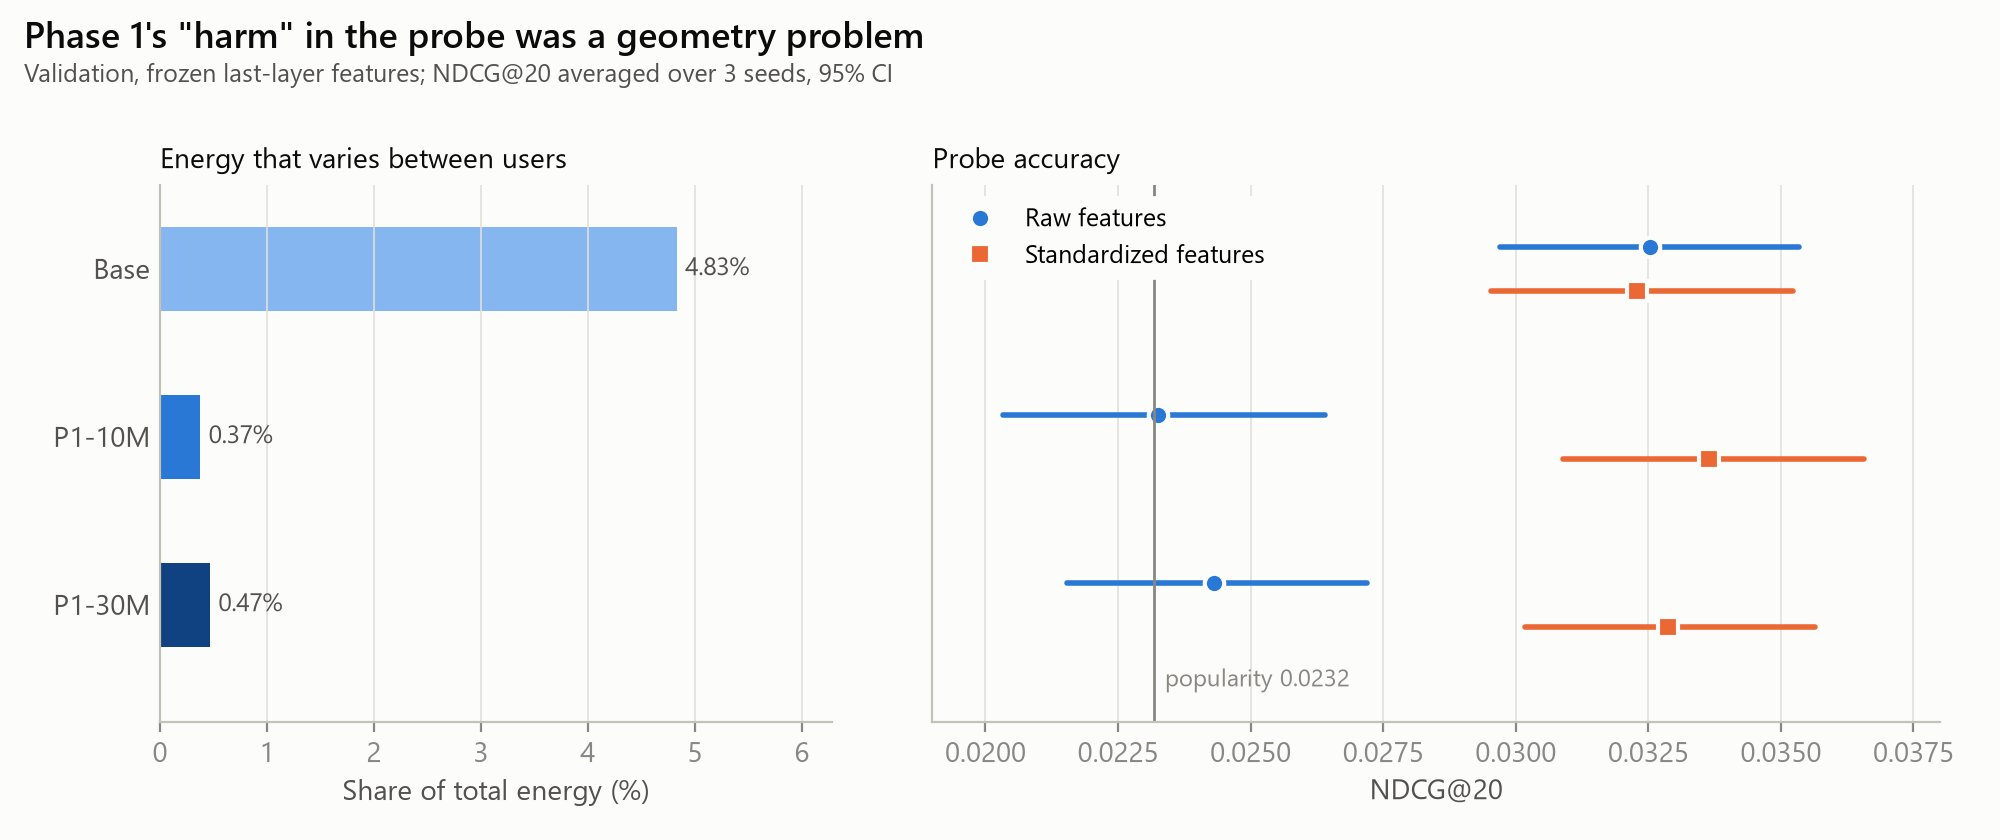
Standartlaştırma Base’e hiçbir şey katmadı (0.0325 → 0.0323), P1 varyantlarını ise popülerlik tabanından alıp Base’in seviyesine taşıdı (P1-10M 0.0233 → 0.0337, P1-30M 0.0243 → 0.0329). Standart P1 - standart Base farkı P1-30M için +0.0006 [-0.0017, +0.0029], P1-10M için +0.0014 [-0.0008, +0.0035]. Açık tamamen kapandı. P1’in “herkese aynı popüler filmleri öneriyor” görüntüsü de aynı etkiden geliyormuş: coverage %3-4’ten %9’a çıktı. Kalan küçük P1 avantajı da yine aynı saniyedeki satırlarda toplanıyor.
Yani resmi karar “Phase 1 zararlı” dese de olan şey başka: Phase 1 bilgiyi bozmuyor, temsilin geometrisini bozuyor. Bu da doğrusal bir head için kötü bir başlangıç noktası yaratıyor. Girdiyi standartlaştırmak bunu düzeltiyor. Backbone’u fine-tune etmek de, head ölü başlamadığı sürece düzeltiyor (LP-FT’de P1-30M’in sürekli yükselmesi gibi). Bu ölçekte Phase 1 ne yardım ediyor ne zarar veriyor. Makalenin +%10-20’sini burada göremedim. Ölçek farkı çok büyük olduğu için bu ne makaleyi doğruluyor ne yanlışlıyor ama zaten ben de makaleyi doğrulamak için değil Phase 1’in etkisini anlamak için bu deneyi yaptım.
Peki hocam bunlar gerçek hayatta ne işimize yarayacak: Modelin canlıya alınması
Buraya kadar hep metrik konuştuk. Gerçek hayatta bir öneri modeli birinin onu çağırıp önerileri alabildiği noktada anlam kazanıyor. Bu yüzden son adım olarak eğittiğim modeli gerçekten kullanılabilir hale getirdim.
Gerçek hayatta bu model şu işi yapıyor;
Kullanıcının puan geçmişini al 16139 filmin her biri için “sıradaki film bu” olasılığını döndür (arkada metin üretimi yok) Prompt’u kur, modelden bir kez geçir Son token’ın vektörünü al ve kataloğu tek bir matris çarpımıyla skorla
Makaledeki prefill-only scoring’in birebir karşılığı 👇🏻
ids, mask = tokenize(prompts)
hidden = body(input_ids=ids, attention_mask=mask).last_hidden_state
user = hidden[torch.arange(len(ids)), mask.sum(1) - 1]
logits = head.score(user, prior=population_prior)
logits[already_rated] = float("-inf")
probs, top = logits.softmax(-1), logits.topk(k)
İlk iş eğitim çıktılarını eğitim verisine ihtiyaç duymayan bir pakete (bundle) dönüştürmek 👇🏻
outputs/serving/p1_30m_lpft/
├── adapter/          # LoRA ağırlıkları (Phase 1 + Phase 2)
├── head.pt           # projeksiyon, 16139 film embedding'i, scale
├── items.parquet     # katalog: movieId, başlık, türler, popülerlik
├── movies.parquet    # 62 bin filmin başlık/tür/tag bilgisi (prompt'u kurmak için)
└── bundle.json       # base model adı, prompt ayarları, metrikler
Paket 53 MB, base model (~1 GB) ise Hugging Face cache’inden geliyor. Buradaki en kritik nokta servis tarafında prompt’un eğitimdekiyle birebir aynı kurulması. Bir boşluk ya da ondalık farkı bile modelin hiç görmediği bir girdi demek (training-serving skew).
Modeli çağırmanın üç yolu var: Python’dan Recommender.from_bundle(...).recommend(istek), komut satırından scripts/recommend.py ve HTTP üzerinden. HTTP için normalde FastAPI kullanırdım ama Claude’nin tercihi http.server ile iki endpoint’lik küçük bir servis oldu.
python scripts\serve_http.py --bundle outputs\serving\p1_30m_lpft
curl -X POST http://127.0.0.1:8000/recommend -H "Content-Type: application/json" --data-binary @request.json
İstek, kullanıcının eskiden yeniye puan geçmişi. Son 20 puan prompt’a giriyor, geçmişteki tüm katalog filmleri öneriden çıkarılıyor. track_movie_ids ile belirli bir filmin kaçıncı sırada olduğunu da sorabiliyoruz. Yazının başındaki aksiyon sever kullanıcıya sıradaki filmi Salt’ı soralım:
# istek
{
  "history": [{"movieId": 1198, "rating": 4.0}, {"movieId": 260, "rating": 3.5}, ..., {"movieId": 3301, "rating": 4.0}],
  "k": 10,
  "track_movie_ids": [79293]
}
# cevap
{
  "recommendations": [
    {"rank": 1, "movieId": 356, "title": "Forrest Gump (1994)", "genres": ["Comedy", "Drama", "Romance", "War"], "score": 9.2816, "probability": 0.005537},
    {"rank": 2, "movieId": 5418, "title": "Bourne Identity, The (2002)", "genres": ["Action", "Mystery", "Thriller"], "score": 9.1718, "probability": 0.004961},
    {"rank": 3, "movieId": 59315, "title": "Iron Man (2008)", "genres": ["Action", "Adventure", "Sci-Fi"], "score": 8.9635, "probability": 0.004028},
    ...
  ],
  "history_items": 94,
  "history_items_in_prompt": 20,
  "excluded_items": 94,
  "prompt_tokens": 800,
  "warnings": [],
  "tracked": [{"movieId": 79293, "title": "Salt (2010)", "rank": 367, "probability": 0.00055}],
  "timing_ms": {"tokenize": 1.94, "forward": 68.69, "score": 1.72, "total": 72.81}
}
Birkaç validation kullanıcısı için iki modelin ilk önerileri yan yana:
| Kullanıcının son puanları | P1-30M ilk 3 | Base ilk 3 | Sıradaki film (P1 / Base sırası) |
|---|---|---|---|
| True Lies, Desperado, Bad Boys II, The Rock | Forrest Gump, Bourne Identity, Iron Man | Avengers, Her, Terminator 2 | Salt (367 / 33) |
| Halloweentown II, Cinderella, Kim Possible | Beauty and the Beast, Harry Potter 1, Brave | Twelve Monkeys, The Village, Avatar | Scooby-Doo! and the Reluctant Werewolf (8787 / 12799) |
| Wind River, Logan, Last Samurai, Batman Begins | Dark Knight Rises, Mad Max: Fury Road, V for Vendetta | Hunger Games: Catching Fire, Captain America, Mad Max: Fury Road | Harry Potter 3 (27 / 204) |
| Batman Returns, X-Files, I Am Legend, Borat | Sherlock Holmes, Finding Nemo, Fight Club | Star Wars VII, The Prestige, Shrek | Harry Potter 6 (53 / 186) |
Tek tek örnekler metrik olarak değil ama modelin ne düşündüğünü görmek için faydalı.
Son olarak bu modelin servis maliyetini ölçtüm:
| Tek istek p50 / p95 | En iyi throughput | VRAM | |
|---|---|---|---|
| LoRA adapter ayrı (PEFT) | 69 / 77 ms | 20 istek/sn (batch 4) | ≤ 2.5 GB |
| LoRA base ağırlıklara birleştirilmiş | 32 / 39 ms | 33 istek/sn (batch 4) | ≤ 2.1 GB |
| CPU (fp32, birleştirilmiş) | 2.2 / 2.3 sn | ~0.5 istek/sn | - |
En büyük kazanç LoRA’yı servis öncesinde base ağırlıklarla birleştirmekten (merge_and_unload()) geldi. 0.06 saniyelik bir işlemle gecikme 2.1 kat düştü. Sıralama neredeyse hiç değişmedi: ilk-20 listelerin %98.7’si aynı, NDCG aynı. CPU’da da çalışıyor ama istek başına ~2 saniye.
Yine de bu haliyle tek başına canlıya alacağım bir model değil. Markov bu modelden 3 kat daha isabetli. Daha mantıklı bir kurgu Markov gibi ucuz bir modelin aday üretmesi ve LLM’in (veya ranking modelinin) de o adayları yeniden sıralaması (reranking) olurdu muhtemelen. Bir de tabii şöyle bir dezavantaj var; katalog eğitimde sabitleniyor. Yeni bir film için embedding olmadığından head’i yeniden eğitmek gerekiyor. Buna karşılık geçmiş tarafı tamamen metin olduğu için kullanıcının geçmişinde katalog dışı, hatta hiç görülmemiş filmler bile olabiliyor.
Sonuç
Başta sorduğum soru “bir LLM’i öneri modeline çevirmek evde ne kadar mümkün?” sorusuydu. Bu soruyu kendime ilk sorduğumda çok daha farklı bir yerden düşünmüştüm ama Netflix makalesi bana en azından başlangıç noktası için bir referans noktası sağladı.
Evdeki GPU ile Phase 1 ve Phase 2’yi de deneyi sonunda 30 ms’de cevap veren bir API’ye sahip olmak mümkün. Ama LLM ile öneri kendi başına bir sihir değil. Bence hala klasik yöntemler büyük ölçekli gerçek hayat problemlerinde etkiye sahip.
Bu ölçekte (0.5B model, 100K örnek) LLM sıralayıcıları popülerliği %31-46 geçiyor ama basit bir item transition modelinin çok gerisinde kalıyor. Phase 1’in makaledeki katkısını da bu ölçekte göremedim. Buna karşılık süreç boyunca en çok şey öğrendiğim yerler sayıların değil, sorunların oldu. Naçizane tecrübem;
- VRAM’i ölçmeden uzun eğitime başlama: Windows’ta bellek taşması (memory offload) hata değil yavaşlık olarak geri dönüyor. Sorun belki benim kullanım şeklimde belki de Windows’ta. Ama 1-2 GB VRAM farkı bile tek bir GPU’da 2 kat hız farkı yaratıyor.
- Boyutlar önemli: Dizi uzunluğunu 64’ün katına yuvarlamak özellik çıkarmayı 2 kat hızlandırdı.
- Önce güçlü ve basit baseline’lar: Markov olmasaydı LLM sıralayıcılarının ne kadar geride olduğunu hiç bilmeyecektim. Basit baseline şart.
- Head’e iyi bir başlangıç ver: Sıfırdan eğitim bu bütçede popülerlik tabanından kalkamadı. Popülerlik prior’ı ve LP-FT ile kalktı.
- Servis öncesi LoRA’yı birleştir ve skew’u test et: Gecikme yarıya iniyor, aynı prompt’un aynı vektörü ürettiğini görmek de sonradan çıkacak sürprizleri önlüyor.
- Windows’un küçük sürprizleri: CUDA uyumlu paketleri bir araya getirmek bazen dertli. Numpy için MKL ve OpenBLAS çakışması ile uğraştım örneğin. O yüzden spesifik ortam (env) yaratmak veya Docker ile doğrudan izole ortam kullanmak daha kolay olabilir.
Toplam GPU süresi kabaca şöyle:
| Adım | Süre |
|---|---|
| Phase 1 (10M + 30M token) | 51 dk + 2 sa 22 dk |
| Özellik çıkarma (Base, P1-30M, P1-10M) | ~1 sa + ~2 sa + ~2 sa |
| Frozen probe’lar (18 koşu) | birkaç dakika |
| End-to-end, sıfırdan (30K) | 1.2 sa |
| LP-FT (3 kol × 100K) | ~10 sa |
| Test değerlendirmesi ve servis ölçümleri | ~15 dk |
| Toplam | ~20 saat |
Toplamda biraz benim tembelliğim biraz hata çözümleri ile yaklaşık 2 haftaya yayılan bir deneme süreci oldu. Makaleyi birkaç kez gözden geçirdim, kodu yazdırdım, veriyi daha önce hiç kurcalamadığım açılardan inceledim, log’ları kontrol etmem gerekti. Bu nedenle olması gereken bir vibe coding çalışmasından ziyade “bu niye böyle ki ya” ile geçen bir yazım süreci oldu. Kafamdaki fine-tuning sorusunu cevaplamak ve pratiğini yapmak yeterli oldu.
Projeyi ChatGPT ile planlayıp ilk aşamalarını onunla yürüttüm, kodun büyük kısmı bu süreçte yazıldı. Sonrasında Claude Code (Opus 5.5) ile eğitim, test ve değerlendirmeleri yaptım.
Kaynaklar
- GenRec: An LLM-Backed Recommendation Ranker at Netflix
- The MovieLens Datasets: History and Context
- Qwen2.5 Technical Report
- LoRA: Low-Rank Adaptation of Large Language Models
- Fine-Tuning can Distort Pretrained Features and Underperform Out-of-Distribution (LP-FT)
- How Contextual are Contextualized Word Representations? (anisotropy)
- PEFT